Fünfzehn Arbeitsproben, die ihre Begründung mitliefern
Regelwerke, Datenwege, kontrollierte KI, ein Supportfall und eine Entscheidung aus eigenen Daten — alle selbst gebaut, alle mit Beispieldaten, keines ein Produkt. Was verbindlich eingestuft wird, entscheiden Regeln, die im Code nachlesbar sind. Wo ein Sprachmodell arbeitet, muss es die Textstelle mitliefern, auf die es sich beruft, und die wird maschinell gegen die Quelle geprüft.
Was hier liegt
- 15 Arbeitsproben – vierzehn in fünf Gruppen, dazu diese Website; jede mit eigener Fallbeschreibung
- 10 davon haben eine Demo, die im Browser läuft, ohne Anmeldung und ohne Server
- 444 Testfälle, die Sie selbst ausführen können
- Regelwerke im Code nachlesbar, KI-Antworten maschinell nachgeprüft
- 0 externe Abhängigkeiten: nichts wird von fremden Servern geladen
Wonach die fünf Gruppen geordnet sind
Nicht nach Technologie und nicht nach Aufwand, sondern nach einer einzigen Frage: Woher kommt hier die Sicherheit, dass das Ergebnis stimmt? Darauf gibt es fünf Antworten, und das sind die fünf Gruppen.
- Regeln, die man nachlesen kann – Die Einstufung trifft eine Regel im Quelltext, kein Modell ist beteiligt.
- KI, kontrolliert eingesetzt – Ein Modell arbeitet, eine Prüfung dahinter entscheidet, ob das Ergebnis gilt.
- Daten holen, prüfen, rechnen – Kein Modell. Der Weg von der Quelle bis zur Prüfabfrage, Schritt für Schritt.
- Technik verstehen und erklären – Kein Regelwerk, sondern Denkarbeit: eingrenzen, widerlegen, erklären.
- Aus Daten eine Entscheidung – Nichts gebaut, sondern etwas entschieden – und die Entscheidung nachgerechnet.
Die fünfzehnte Arbeitsprobe steht außerhalb dieser Ordnung: Sie ist diese Website selbst.
Stand · 1. Oktober 2026
Der gemeinsame Grundsatz: Jeder Treffer schreibt seinen Beleg mit. Kein Werkzeug hier füllt eine Lücke mit einer plausiblen Zahl – es weist sie als Lücke aus. Das ist der Unterschied, an dem sich alle fünfzehn messen lassen.
Gruppe 1 von 5
Regeln, die man nachlesen kann
Fünf Werkzeuge, die eine wiederkehrende Sortierarbeit übernehmen. Drei davon sind in mehreren Versionen gebaut: erst ein Skript, dann eine Oberfläche, dann eine Stufe, in der ein Sprachmodell mitarbeitet – aber nichts entscheidet.
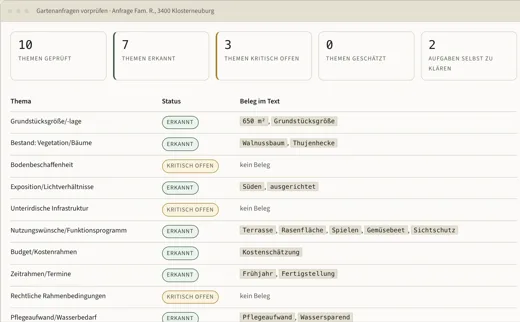
Gartenanfragen vorprüfen
Prüft eine formlose Anfrage gegen eine fachliche Checkliste aus zehn Themen und zeigt, was vor dem Erstgespräch noch zu klären ist – mit dem Wort aus dem Text, das den Treffer ausgelöst hat.
Gebaut: Python-Skript · Browser-Oberfläche · KI-Rückfragen mit Belegprüfung · Modellvergleich
Fallbeschreibung · 12 Min. →
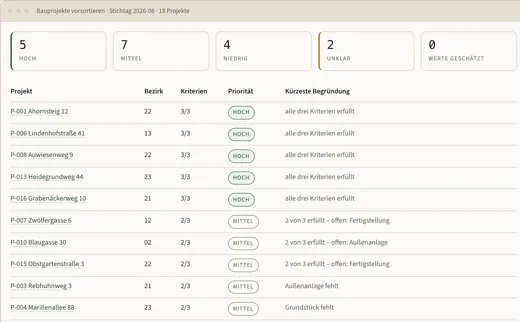
Bauprojekte vorsortieren
Prüft 18 Bauprojekt-Datensätze gegen drei offen dokumentierte Kriterien und erzeugt eine priorisierte Arbeitsliste – einschließlich der Projekte, die sich mangels Angaben nicht einstufen lassen.
Gebaut: Python-Skript · Browser-Oberfläche mit Belegspalte · eigener Zustand für „nicht bewertbar“
Fallbeschreibung · 7 Min. →
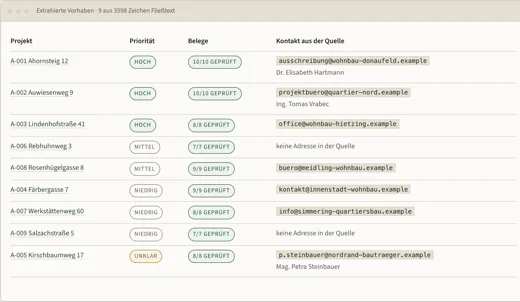
Aus einem Rundbrief eine Arbeitsliste
Derselbe Fall, aber ab dem unstrukturierten Text: Ein Agent löst die Projekte aus einem Rundbrief heraus und übergibt sie an dasselbe Regelwerk. Der Lauf ist aufgezeichnet.
Gebaut: Agentenlauf über unstrukturierten Text · Übergabe an das Regelwerk · aufgezeichneter Lauf
Fallbeschreibung · 4 Min. →
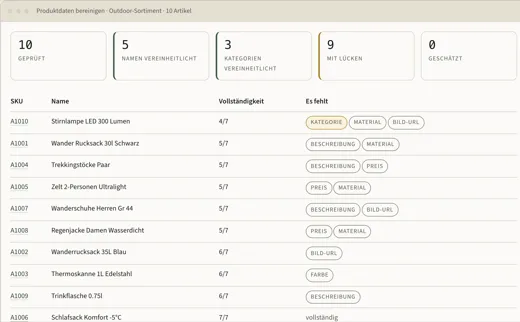
Produktdaten bereinigen, ohne zu raten
Vereinheitlicht Kategorien und Produktnamen nach festen Regeln und listet getrennt davon auf, welche Pflichtangaben je Artikel fehlen. Erfindet keine einzige Angabe.
Gebaut: Python-Skript · Browser-Oberfläche mit Vorher-Nachher je Feld · KI-Vorschläge mit Nachprüfung
Fallbeschreibung · 11 Min. →
Ausschreibung gegen belegbare Fakten
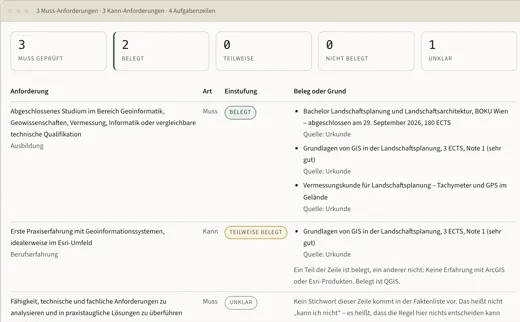
Löst aus einer Stellenausschreibung die einzelnen Anforderungen heraus und stuft jede in einen von vier Zuständen ein: belegt, teilweise belegt, nicht belegt, unklar.
Gebaut: Browser-Regelwerk · feste Liste aus 28 belegten Fakten · vier Zustände statt einer Note
Fallbeschreibung · 4 Min. →
Gruppe 2 von 5
KI, kontrolliert eingesetzt
Zwei Fälle, in denen ein Sprachmodell echte Arbeit macht – und in beiden entscheidet nicht das Modell, ob das Ergebnis stimmt. Die Modellläufe sind echt und aufgezeichnet, samt Tokenverbrauch und Kosten.
Ein Dokument, ein Modell, neun Prüfungen
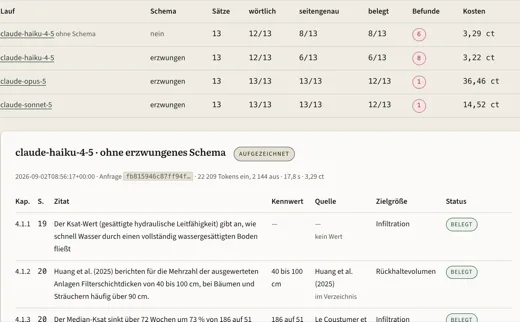
Ein Sprachmodell zieht 13 Planungsparameter aus 16 Seiten Fachtext – je einen pro Unterkapitel, mit Kennwert, Seitenzahl und Zitat. Ein Zeichenvergleich hält jede Angabe gegen das Original.
Gebaut: Extraktion mit Belegzwang · neun Prüfungen, Fehlerklassen E1–E6 · Fehlerlogbuch · Modellvergleich mit Kosten in Cent · Freigabeablauf mit Fehlerpfad
Fallbeschreibung · 18 Min. →
Make gegen Zapier, an einer echten Strecke
Eine laufende Notion-Zapier-Strecke, viermal aufgezeichnet. Auf den erfundenen Pflanzennamen kam kein Datensatz zurück, sondern ein Fehler. Der Vergleich zweier Läufe fand außerdem einen Fehler in der Datenbank selbst.
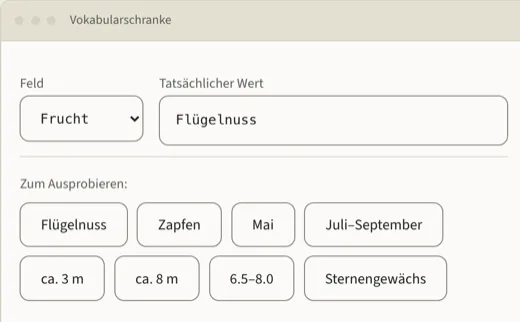
Gebaut: Notion-Datenmodell mit 31 Feldern · Make- und Zapier-Strecke im Vergleich · Halluzinationstest · Vokabularschranke
Fallbeschreibung · 17 Min. →
Gruppe 3 von 5
Daten holen, prüfen, rechnen
Drei Arbeitsproben ohne Sprachmodell: zweimal der Weg von einer fremden Schnittstelle bis zum geprüften Bestand, einmal dieselbe Sorgfalt ganz ohne Code, in einer Tabellenkalkulation.
378 Bilddatensätze, acht Prüfabfragen
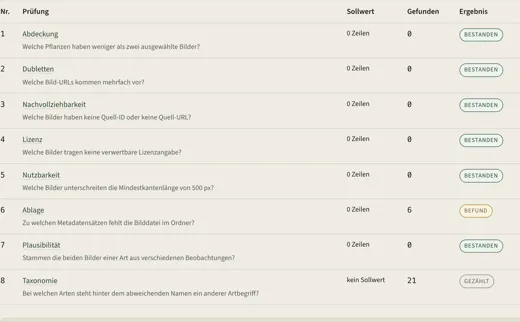
Metadaten zu 189 Gehölzarten über die iNaturalist-Schnittstelle geholt, in eine SQLite-Datenbank überführt und geprüft. Ein Befund aus dem eigenen Bestand: sechs fehlende Dateien.
Gebaut: Python-Programm gegen die iNaturalist-API · SQLite mit vier Tabellen · acht Prüfabfragen als SQL und JavaScript
Fallbeschreibung · 10 Min. →
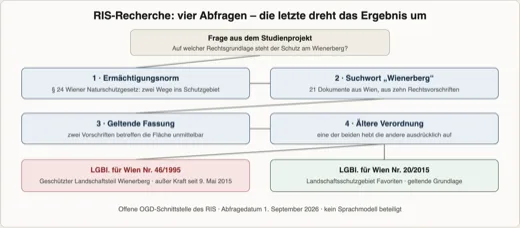
Rechtsbestand aus dem RIS
Welche Verordnung gilt auf einer bestimmten Fläche? Beantwortet über die offene Schnittstelle des österreichischen Rechtsinformationssystems – jeder Treffer mit seinem Abfragedatum.
Gebaut: Abfrage über die OGD-Schnittstelle des RIS · Trefferprüfung · datiertes Rechercheprotokoll
Fallbeschreibung · 4 Min. →
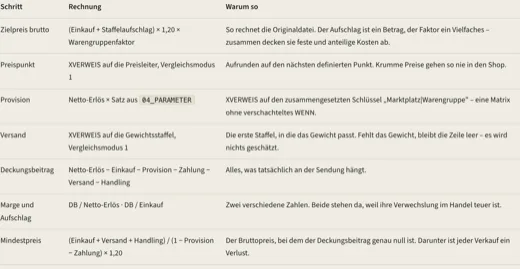
Was bleibt nach Provision und Versand?
Rechnet aus Einkaufspreis, Provision, Versand und Umsatzsteuer den Deckungsbeitrag – mit Szenarioschaltern. 40 Artikel, 8 Prüfungen, keine fest eingetragene Zahl in den Rechenblättern.
Gebaut: Power Query · Pivot · VBA-Modul · acht eingebaute Prüfungen · Szenarioschalter
Fallbeschreibung · 6 Min. →
Gruppe 4 von 5
Technik verstehen und erklären
Vier Arbeitsproben an derselben realen Anlage – vom Aufbau über den Störfall und die Wissensbasis bis zum Angebot. Sie zeigen die Arbeit, die im Profil selten auftaucht: herausfinden, woran es liegt, und es jemandem erklären, der es nicht studiert hat.
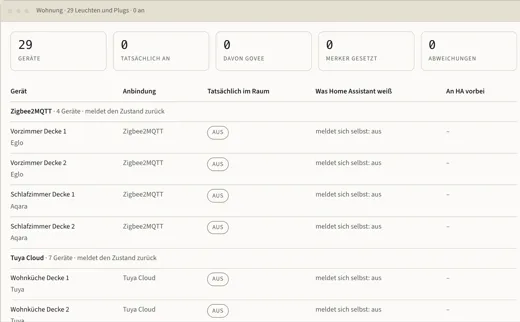
Zehn Ökosysteme, fünf Anbindungswege, ein Zustand
Geräte, die miteinander nicht sprechen wollen, über fünf Anbindungswege zusammengeführt. Für die zwölf Leuchten ohne Zustandsmeldung führt das System selbst Buch.
Gebaut: 129 Geräte aus zehn Herstellerwelten · fünf Anbindungswege · eigene Zustandsverwaltung
Fallbeschreibung · 7 Min. →
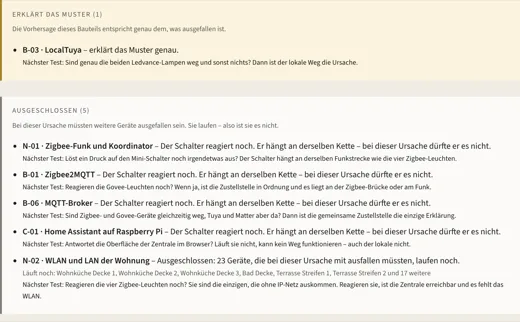
Ein Störungsbild, fünf Wege
Vom Symptom bis zur Ursache: fünf Hypothesen, vier davon widerlegt. Die Ursache stand am Ende auf keinem Datenblatt. Dazu die Wissensbasis zur Anlage und das Angebot, das aus der Diagnose folgt.
Gebaut: Systemmodell der Anlage mit Ausfallmustern · fünf Störfälle · Diagnoseweg als Textfassung · 20 Supportfragen mit Prüfreihenfolge · Musterangebot mit Ausschlüssen und Nachfassnotiz
Fallbeschreibung · 26 Min. →
Gruppe 5 von 5
Aus Daten eine Entscheidung
Die übrigen Arbeitsproben zeigen etwas Gebautes. Diese zwei zeigen den Schritt davor: aus eigenen Daten eine Entscheidung ableiten, die etwas gekostet hätte, wenn sie falsch gewesen wäre – und danach das Werkzeug bauen, das die kritische Annahme überwacht.
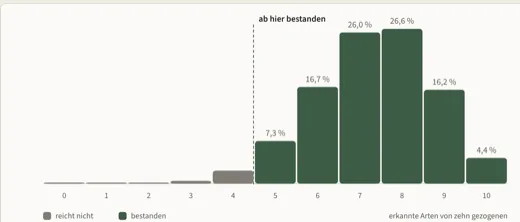
1.300 Altprüfungen, 189 Arten
Von 547 prüfungsrelevanten Gehölzarten wurden in den Altprüfungen nur 189 je abgefragt. Was es kostet, den Rest wegzulassen, steht als Rechnung da – mit drei Annahmen statt einer Zahl.
Gebaut: Auszählung aus zwei Plattformen · Wahrscheinlichkeitsmodell mit Sensitivität · Schwellenrechnung · Gegenprobe per Simulation
Fallbeschreibung · 9 Min. →
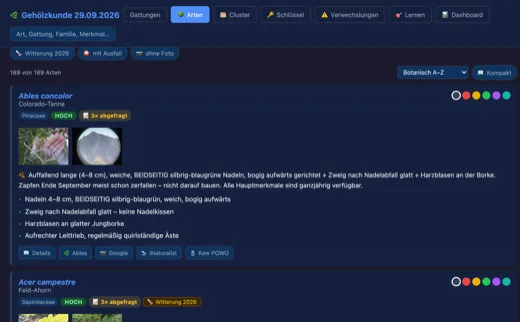
Ein Bestimmungswerkzeug für 189 Arten
189 Arten, acht Ansichten, fünf Quizmodi und ein vollständiger Bestimmungsschlüssel – in einer HTML-Datei, die im Browser läuft. Der Lernstand misst genau die Annahme, an der die Rechnung hängt.
Gebaut: Acht Ansichten · fünf Quizmodi mit echten Verwechslungsarten · 462 Verwechslungspaare · 371 Fotos mit Lizenz · Lernstand in sechs Farben
Fallbeschreibung · 3 Min. →
Was diese Arbeitsproben bewusst nicht sind
Keine Produkte, keine Plattformen. Sie arbeiten mit Beispieldaten, nicht mit echten Kunden- oder Personendaten, und sie versprechen keine Marktreife. Was sie zeigen, ist die Arbeitsweise dahinter: ein Problem zerlegen, Regeln dafür aufschreiben, das Ergebnis prüfbar machen.
Keine Berufserfahrung als Entwickler. Ich habe keine Stelle innegehabt, in der Programmieren die Aufgabe war. Was hier liegt, ist neben dem Studium und neben der Arbeit im Handel entstanden, für eigene Zwecke.
Und kein Beleg dafür, dass die Inhalte fachlich stimmen. Die Werkzeuge prüfen die Form: Steht der Wert in der Liste? Trägt der Treffer seine Textstelle? Ob eine Pflanze tatsächlich bis −30 °C winterhart ist, prüft keines von ihnen – und dort, wo das auffällt, steht es auf der jeweiligen Seite.
Wenn Sie so etwas besetzen
Wenn Sie eine Rolle in Daten, Prozessen, Digitalisierung oder technischem Support besetzen: Alle fünfzehn Arbeitsproben stehen offen, zehn davon mit einer Demo, die im Browser läuft – ohne Anmeldung, ohne Konto, ohne dass ich etwas davon erfahre.