Anforderung, Regelwerk, Prüfschritt, Übergabepunkt
Bei Ihnen bleibt die Datenarbeit liegen, weil sie niemand gern übernimmt? Zehn Belege, gelesen als das, was sie sind: dokumentierte Prozesse mit definiertem Auslöser, nachlesbarem Regelwerk, maschineller Prüfung und einem klar gesetzten Punkt, an dem der Mensch übernimmt.
Jeder dieser Belege beginnt mit einer fachlichen Anforderung, nicht mit einer Technologie. Erst wird festgelegt, was gelten soll – welche zehn Themen eine Gartenanfrage abdecken muss, welche drei Kriterien ein Bauprojekt einstufen, welche Angaben ein Artikel zwingend braucht. Dann erst entsteht das Regelwerk, das diese Festlegung anwendet.
Die verbindliche Einstufung übernehmen immer Regeln, die im Code nachlesbar sind. Wo ein Sprachmodell dazukommt – zum Formulieren, Extrahieren oder als zweite Meinung –, muss es die Textstelle mitliefern, auf die es sich beruft, und diese Angabe wird maschinell gegen die Quelldaten geprüft. Was den Beleg nicht besteht, wird verworfen und nicht angezeigt.
Fehlende Angaben werden als fehlend ausgewiesen und nie geschätzt. „Nicht bewertbar“ ist beim Vorsortieren der Bauprojekte ein eigener Zustand, kein schlechter Wert – die Unterscheidung entscheidet darüber, ob eine Arbeitsliste brauchbar ist oder nur vollständig aussieht.
Zu jedem Werkzeug gehört ein Abschnitt „Grenzen“, in dem steht, was es nicht kann. Insgesamt laufen 444 Regeltests im Browser – gegen dasselbe Regelwerk wie die Auswertung, nicht gegen eine Kopie.
Der Übergabepunkt
Automatisierung übernimmt Einlesen, Prüfen, Sortieren und Begründen. Der Mensch legt die Kriterien fest, interpretiert das Ergebnis und entscheidet. Dieser Schnitt ist in jedem Fall ausdrücklich benannt und im Ablaufdiagramm markiert.
Praxis dahinter
36.000 Artikel über rund 200 Kategorien im PIM-System von Birner gepflegt und die Kategorienstruktur laufend weiterentwickelt – projektbasierte Teilzeit, 11 Stunden pro Woche. Von Mai bis Oktober 2026 im Marketing der SeneCura, laut Dienstzeugnis mit „Schnittstellenfunktion zwischen den Häusern, internen Ansprechpartner:innen und externen Agenturen“.
Woher ich komme – und wo die Grenze liegt
Ich komme aus der Fachseite, nicht aus der IT. Als Anforderungs- oder Prozessmanager war ich nicht angestellt, eine Projektleitung in einem IT-Vorhaben habe ich nicht geführt, und die zehn Belege sind Arbeitsproben mit Beispieldaten, keine Produkte im Kundeneinsatz. Genau daher kommt aber der Zuschnitt: Ich schreibe die fachliche Regel selbst, bevor ich sie automatisiere – und muss mir die Aufgabe nicht erst erklären lassen.
Zehn Belege
-
Ein Dokument, ein Modell, neun Prüfungen
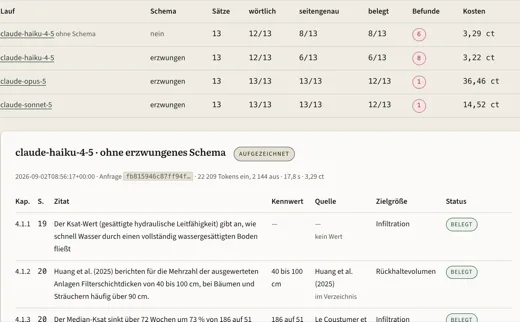
im Browser ausführbarEin Sprachmodell liest 16 Seiten Fachtext und zieht daraus 13 Planungsparameter – je einen pro Unterkapitel, mit Kennwert, Seitenzahl und wörtlichem Zitat. Danach entscheidet kein zweites Modell, ob das stimmt, sondern ein Zeichenvergleich gegen das Original: Steht das Zitat wirklich dort, auf der genannten Seite, mit dem Kennwert im Zitat und einer Quelle, die im Literaturverzeichnis steht? Neun Prüfungen, Fehlerklassen E1 bis E6.
Vier aufgezeichnete Läufe mit zeichengleicher Anfrage – Opus 5, Sonnet 5, Haiku 4.5 und einer ohne erzwungenes Antwortschema. Zwei belegten alle 13 Parametersätze seitengenau, einer traf 6 von 13, und drei von vier stolperten an derselben Stelle über einen Fehler in meiner Aufgabenstellung. Dazu der Kostenvergleich in Cent, ein Fehlerlogbuch und ein Ablauf mit Fehlerpfad, dessen Ergebnis erst gilt, wenn ein Mensch unterschreibt.
-
378 Bilddatensätze, acht Prüfabfragen
im Browser ausführbarEin Python-Programm holt zu 189 Gehölzarten je zwei lizenzierte Fotos über die iNaturalist-API und schreibt zu jedem Bild einen Metadatensatz. Aus diesen Metadaten entsteht eine kleine SQLite-Datenbank mit vier Tabellen und acht Abfragen, die den Bestand prüfen: Abdeckung, Dubletten, Quell-IDs, Lizenzen, Auflösung, Ablage, Plausibilität, Taxonomie.
Sechs Abfragen finden nichts, eine findet etwas – sechs Metadatensätze ohne Bilddatei, und zwar genau die der drei Arten, die das Programm selbst zur Prüfung vorgelegt hatte. Der Befund wurde nicht weggeräumt, weil eine Prüfung, deren Ergebnisse man aufräumt, nichts mehr prüft. Auf derselben Seite ein zweiter Fall an einer ganz anderen Datenbank: eine RIS-Recherche, die eine seit 2015 aufgehobene Verordnung findet.
-
Make gegen Zapier – vier Läufe, einer mit einer Pflanze, die es nicht gibt
vier Läufe aufgezeichnetEin Datenmodell mit 31 Feldern, davon 24 mit kontrolliertem Vokabular, und eine Zapier-Strecke, die es über ein Sprachmodell füllt. Vier aufgezeichnete Läufe: der Normalfall, dieselbe Pflanze von der anderen Seite, ein erfundener Name und eine Hybride. Auf den erfundenen Namen kam kein Datensatz zurück, sondern ein Fehlerobjekt – abgefangen hat ihn aber weder Filter noch Code, sondern das Modell. Das steht auf der Seite als das, was es ist: ein gutes Ergebnis und eine dünne Absicherung.
Der Vergleich zweier Läufe derselben Pflanze fand einen Fehler, den keine Einzelprüfung gezeigt hätte: Die Werteliste führt
Mehrjährig (lang lebend)undMehrjährig (langlebend)als zwei Optionen. Beide Läufe wählten korrekt – nur nicht dasselbe.Dazu die Prüfung des Datenbestands mit drei Befunden. Der teuerste: Das Feld
Winterhärteführt-15 °Czweimal, einmal mit Bindestrich, einmal mit Gedankenstrich. Ein Filter darauf findet die Hälfte der Pflanzen und meldet keinen Fehler. Make war der erste Versuch und wurde im Oktober/November 2025 abgebrochen, weil die Anbindung von OpenAI-API und Notion umständlicher war; weitergebaut wurde in Zapier, trotz des technischeren Interfaces. Der Befund ist datiert und heute womöglich überholt – das steht auf der Seite.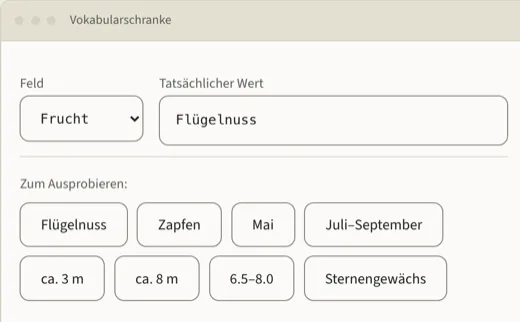
-
Ausschreibung gegen belegbare Fakten – Anforderungen aus einem Fließtext herauslösen
im Browser ausführbarEin Werkzeug, das eine Stellenausschreibung in einzelne Anforderungen zerlegt, Muss von Kann trennt und beides von der Aufgabenbeschreibung – und jede Zeile gegen eine feste Faktenliste prüft. Vier Einstufungen, zu jeder die Quelle. Keine Prozentzahl, keine Empfehlung.
Der interessante Teil ist die vierte Einstufung: unklar. Sie steht für Zeilen, zu denen die Regel nichts entscheiden kann, und ist bewusst kein Papierkorb. Ein Sprachmodell würde diese Zeilen zuordnen – auch dort, wo es nichts zuzuordnen gibt.
-
Excel-Arbeitsmappe zum Herunterladen und Aufmachen
Datei prüfbar40 Artikel mit absichtlich unsauberen Rohdaten: eine Warengruppe in vier Schreibweisen, eine Zahl als Text, drei fehlende Werte, eine doppelte Artikelnummer, ein negativer Bestand. Die Mappe vereinheitlicht, kalkuliert mit XVERWEIS über zusammengesetzte Schlüssel, wertet nach Warengruppe und Marktplatz aus und führt acht Prüfungen – sie ergänzt keinen einzigen fehlenden Wert.
Power Query und das Makro liegen als eigene, importierbare Dateien daneben, weil sich beides nicht in einer maschinell erzeugten Mappe unterbringen lässt. Was fehlt, steht in der Datei selbst – im Blatt
01_README, nicht im Kleingedruckten. -
Gartenanfragen vorprüfen – gegen eine fachliche Anforderungsliste
im Browser ausführbarAuslöser: eine formlose Projektanfrage. Regelwerk: zehn fachlich definierte Themen. Prüfschritt: jeder Treffer wird mit dem auslösenden Stichwort ausgewiesen. Ausgabe: erkannt, kritisch offen, nicht blockierend. Übergabe: ein Mensch gibt die formulierten Rückfragen frei.
Dokumentiert ist auch ein gefundener Fehler: Das Wort
erdaushubgalt einmal als Beleg dafür, dass die Bodenbeschaffenheit geklärt sei – fachlich falsch. Aufgefallen ist es nur, weil jeder Treffer sein Stichwort mitschreibt.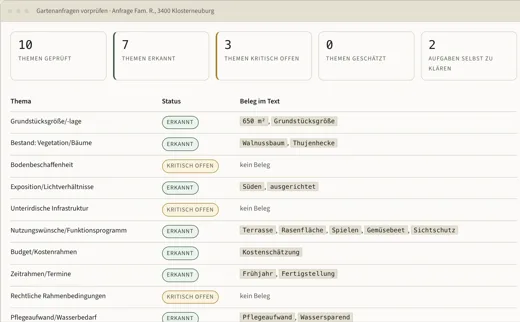
-
Bauprojekte vorsortieren – mit einem eigenen Zustand für „nicht bewertbar“
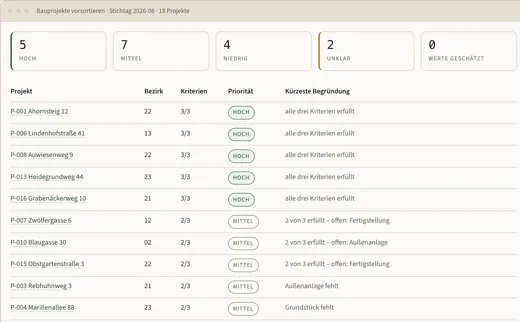
im Browser ausführbar18 Datensätze, drei offen dokumentierte Kriterien, genau eine Prioritätsklasse je Projekt und zu jeder Einstufung ein Begründungssatz. Fehlende und ungültige Angaben werden getrennt behandelt. Eine weitere Version setzt eine Ebene früher an, beim unstrukturierten Rundbrief.
-
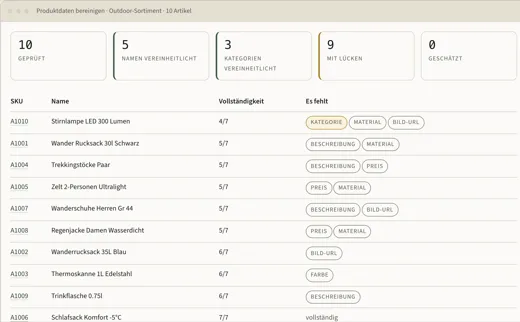
Produktdaten bereinigen – Normalisierung und Lückenreport, strikt getrennt
im Browser ausführbarZwei Ausgaben statt einer: die bereinigte Datei und der Report über fehlende Pflichtangaben. Abkürzungen und Maßangaben bleiben unangetastet, kein Wert wird ergänzt. Die Browser-Fassung liefert für dieselbe Eingabe zeichengleich dasselbe Ergebnis wie das Python-Skript.
-
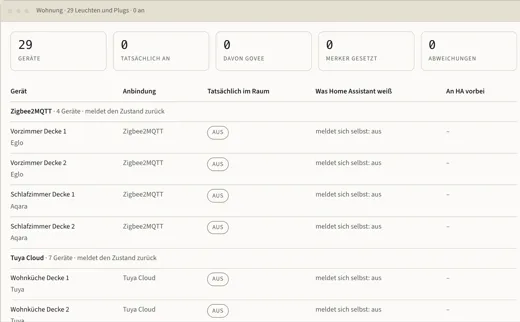
129 Geräte aus zehn Hersteller-Ökosystemen, 50 aktive Automatisierungen; allein die Beleuchtung läuft über fünf Anbindungswege. Für zwölf Leuchten ohne Zustandsrückmeldung führt das System selbst Buch darüber, was es geschaltet hat. Die Fallbeschreibung benennt den Tausch, den diese Lösung eingeht, und ihre Fehlerfälle.
-
Diese Website – Anforderung, Umsetzung, Prüfung
Sie lesen sie geradeDer direkteste Kompetenznachweis auf dieser Seite ist die Seite selbst. Ich habe sie ohne Vorerfahrung in HTML, CSS oder JavaScript gebaut: Anforderungen und Struktur festgelegt, Entwürfe verworfen und angenommen, Inhalte verantwortet, das Ergebnis geprüft und veröffentlicht. Ein Sprachmodell hat den Code geschrieben.
Welche technischen Entscheidungen warum gefallen sind – statisches HTML ohne Framework, kein Tracking, keine externen Abhängigkeiten, alle Demos ohne Server –, steht offen auf Diese Seite, samt dem Abschnitt darüber, was daran schiefgegangen ist.
Kontakt
Wenn Sie eine Einsteigerstelle in Prozessen, Anforderungen oder Datenqualität besetzen: Ich bin in Wien und Umgebung verfügbar; der Bachelor ist seit 29. September 2026 abgeschlossen.
Für Unterlagen, die auf Papier in den Akt gehen, liegt diese Seite als A4-PDF bereit – ohne Navigation, mit ausgeschriebenen Link-Adressen und geschützten Seitenumbrüchen. Strg + P beziehungsweise Cmd + P erzeugt dieselbe Fassung selbst.
E-Mail schreiben Lebenslauf ansehen Alle Kontaktwege Diese Seite (PDF, 6 Seiten)
Falls sich kein Mailprogramm öffnet:
niklas.bram.business@gmail.com ·
über LinkedIn schreiben
Für ein kurzes Gespräch genügt es, mir zwei Zeitfenster zu nennen –
eine ausformulierte Anfrage brauche ich dafür nicht.