Python-Skript und Browser-Fassung
Produktdaten bereinigen, ohne zu raten
Wer einen Produktkatalog pflegt, kennt beides: Schreibweisen, die über Jahre auseinanderlaufen, und Pflichtfelder, die leer bleiben. Auffallen tut das erst, wenn ein Export scheitert oder ein Artikel nicht gefunden wird. Dieses Werkzeug vereinheitlicht nach festen Regeln und listet getrennt davon auf, welche Angabe bei welchem Artikel fehlt – geschätzt wird nichts.
Produktdaten vereinheitlichen und Lücken sichtbar machen – ohne eine einzige Angabe zu erfinden.
Die Regeln in vier Sätzen
- Vereinheitlichen und Ergänzen sind zwei getrennte Aufgaben
- Abkürzungen und Maßangaben bleiben unangetastet
- fehlende Pflichtangaben werden je Artikel gelistet
- keine erfundene Angabe – auch nicht bei den KI-Vorschlägen
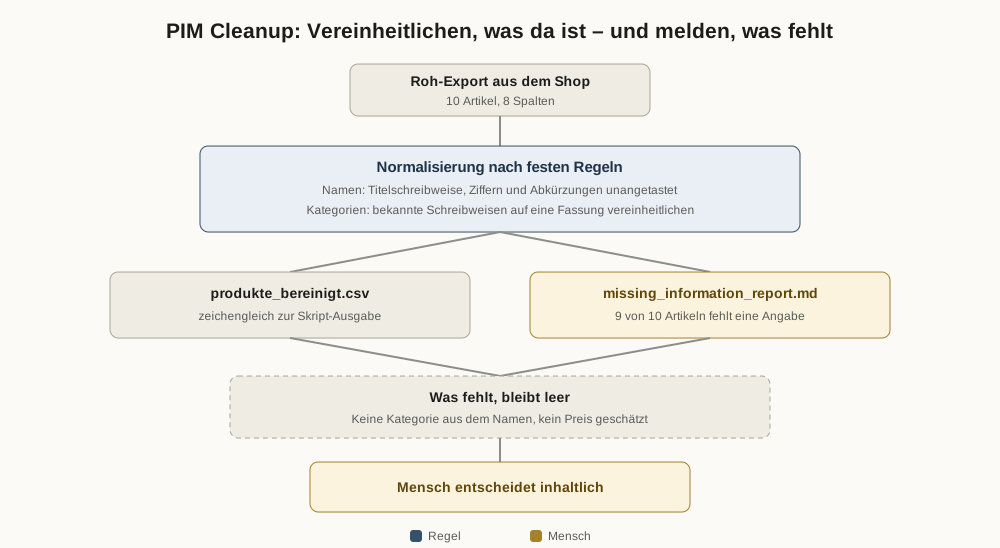
Der Fall als Prozess
- Auslöser
- Ein Roh-Export aus einem Shop- oder PIM-System soll vor der Weiterverarbeitung aufgeräumt werden.
- Eingangsdaten
- Zehn Beispielartikel mit uneinheitlichen Produktnamen, uneinheitlichen Kategorien und fehlenden Pflichtangaben.
- Regelwerk
- Feste Normalisierungsregeln für Namen und Kategorien. Abkürzungen und Maßangaben bleiben unangetastet.
- Prüfschritt
- Je Artikel wird geprüft, welche Pflichtangaben fehlen. Kein fehlender Wert wird ergänzt oder geschätzt.
- Ausgabe
- Zwei getrennte Dateien: die bereinigte Produktdatei und der Report über die Lücken – bei 9 von 10 Artikeln.
- Übergabepunkt
- Welche Lücke wie geschlossen wird, entscheidet der Mensch mit Zugriff auf die Quelle.
- Grenze
- Das Werkzeug prüft Form, nicht fachliche Richtigkeit. Ein falscher, aber formal vollständiger Wert bleibt unentdeckt.
Was es tut
Vereinheitlicht Kategorien und Produktnamen nach festen Regeln, lässt Abkürzungen und Maßangaben unangetastet und listet getrennt davon auf, welche Pflichtangaben je Artikel fehlen. Erfindet keinen einzigen Wert.
In E-Commerce-Begriffen: Es geht um Produktdatenqualität und Attributvollständigkeit – uneinheitliche Kategorienstruktur, uneinheitliche Artikelbezeichnungen und fehlende Pflichtattribute sind genau die Fehler, die im Shop zu leeren Filtern, schlechter interner Suche und unbrauchbaren Feed-Exporten führen.
Der Fall stammt nicht aus der Theorie: Bei Birner habe ich 36.000 Artikel über rund 200 Kategorien im PIM-System gepflegt und die Kategorienstruktur laufend weiterentwickelt – Artikelbezeichnungen, Beschreibungen, Attribute und die Zuordnung der Mediendaten für den Webshop (Werdegang).
Ausgangslage
Produktdaten aus einem Shop- oder PIM-Export sind selten einheitlich. In den Beispieldaten – zehn Artikel aus dem Outdoor-Bereich – treten mehrere typische Probleme nebeneinander auf:
-
Uneinheitliche Namen:
wander rucksack 30l schwarzsteht nebenTHERMOSKANNE 1L EDELSTAHL. -
Uneinheitliche Kategorien: dieselbe Warengruppe
erscheint als
Rucksäckeund alsrucksack, dazuREGENBEKLEIDUNGundschlafsäckemit angehängtem Leerzeichen. - Fehlende Pflichtangaben: Beschreibung, Preis, Material, Farbe oder Bild-URL fehlen – bei einem Artikel sogar die Kategorie.
Solange beides vermischt bleibt, ist beides mühsam: Man kann die Daten nicht sauber sortieren, und man sieht nicht, wo noch inhaltliche Arbeit ansteht.
Diese Arbeit habe ich bei Birner fünf Monate lang im PIM-System von Hand gemacht — Artikel kategorisieren, Schreibweisen vereinheitlichen, Lücken melden. Die Regeln in diesem Skript sind die, die ich damals im Kopf hatte. Zum Werdegang →
Warum Vereinheitlichen und Ergänzen zwei getrennte Aufgaben sind
Vereinheitlichen ist eine Regelaufgabe – das kann ein Skript zuverlässig und immer gleich.
Fehlende Inhalte ergänzen ist eine inhaltliche Aufgabe – das kann nur ein Mensch, der das Produkt kennt.
Die Demo trennt beides sauber: eine bereinigte Datei und eine getrennte Liste dessen, was noch fehlt. Nichts wird aus dem Namen abgeleitet oder geschätzt.
Ablauf
Version 1 · Python-Werkzeug
läuftLiest die Rohdaten, wendet die Regeln an und schreibt zwei Ergebnisdateien. Bricht mit einer verständlichen Meldung ab, wenn die Datei fehlt, leer ist oder eine Pflichtspalte fehlt.
Vorher · produkte_roh.csv
A1002,Wanderrucksack 35L Blau,rucksack,
  84.90,Blau,Nylon,

A1008,Regenjacke Damen wasserdicht,
  REGENBEKLEIDUNG,,rot,,https://…/a1008.jpg

A1010,Stirnlampe LED 300 Lumen,,
  19.90,schwarz,,
Nachher · produkte_bereinigt.csv
A1002,Wanderrucksack 35L Blau,Rucksäcke,
  84.90,Blau,Nylon,

A1008,Regenjacke Damen Wasserdicht,
  Regenbekleidung,,rot,,https://…/a1008.jpg

A1010,Stirnlampe LED 300 Lumen,,
  19.90,schwarz,,
Auszug aus 10 Zeilen, Umbrüche zur Lesbarkeit eingefügt. Die
Kategorien sind vereinheitlicht,
LED bleibt groß – und die leeren Felder sind unverändert
leer geblieben.
Geprüfte Datensätze: 10

Kategorien automatisch vereinheitlicht: 3
Produkte mit mindestens einer fehlenden Pflichtangabe: 9/10

Dieses Skript hat KEINE fehlenden Werte erfunden oder geschätzt.
Alles unten Gelistete braucht eine menschliche Entscheidung.

- **A1002** (Wanderrucksack 35L Blau): fehlt Bild-URL
- **A1008** (Regenjacke Damen Wasserdicht): fehlt Preis, Material
- **A1010** (Stirnlampe LED 300 Lumen): fehlt Kategorie, Material, Bild-URL
Quellcode ansehen – Abkürzungsliste und Namensregel
# Abkürzungen, die in Produktnamen groß bleiben sollen. Bewusst eine kurze,
# explizite Liste: Das Skript rät nicht, welches Wort eine Abkürzung ist.
ABBREVIATIONS = {"LED", "UV", "XL", "XXL"}

# Kategorie-Mapping: verschiedene Schreibweisen -> eine kanonische Kategorie
CATEGORY_MAP = {
    "rucksäcke": "Rucksäcke",
    "rucksack": "Rucksäcke",
    "trinkflaschen": "Trinkflaschen",
    "zubehör": "Zubehör",
    "zelte": "Zelte",
    "schlafsäcke": "Schlafsäcke",
    "schuhe": "Schuhe",
    "regenbekleidung": "Regenbekleidung",
}

def normalize_name(raw: str) -> str:
    """Titelcase, aber Maßeinheiten/Zahlen und bekannte Abkürzungen unangetastet."""
    if not raw:
        return raw
    words = raw.strip().split()
    fixed = []
    for w in words:
        # Wörter mit Ziffern (30l, -5°C, 44) so lassen wie sie sind
        if any(ch.isdigit() for ch in w):
            fixed.append(w)
        elif w.upper() in ABBREVIATIONS:
            fixed.append(w.upper())
        else:
            fixed.append(w.capitalize())
    return " ".join(fixed)
Die Normalisierungsregeln sind durch neun kleine Tests abgesichert
(python3 pim_cleanup.py --selftest). Dieselben Regeln
laufen als JavaScript-Portierung im Browser – dort gegen 24 Testfälle,
die Sie selbst ausführen können. Zusammen mit der Nachprüfung aus
Version 3 sind es 87.
Version 2 · Oberfläche
läuftDie Lückenliste als Arbeitsansicht statt als Textdatei. Diese Oberfläche ist gebaut und bedienbar: Das Regelwerk wurde nach JavaScript portiert und läuft im Browser des Besuchers. Für denselben Datensatz erzeugt sie zeichengleich denselben Report und dieselbe bereinigte CSV wie das Python-Skript oben – beide Dateien lassen sich in der Demo aufklappen und vergleichen.
Ein Klick auf eine Zeile öffnet den Vorher-Nachher-Vergleich: jedes Feld mit Rohwert, bereinigtem Wert und der Regel, die gegriffen hat. Dort steht auch, wo das Regelwerk bewusst nichts tut – etwa bei einer Kategorie, die es nicht kennt und deshalb unverändert stehen lässt.
Bereinigung in der Demo ausführen →
| SKU | Name | Vollständigkeit | Es fehlt |
|---|---|---|---|
| A1010 | Stirnlampe LED 300 Lumen | 4/7 | Kategorie Material Bild-URL |
| A1008 | Regenjacke Damen Wasserdicht | 5/7 | Preis Material |
| A1004 | Trekkingstöcke Paar | 5/7 | Beschreibung Preis |
| A1002 | Wanderrucksack 35L Blau | 6/7 | Bild-URL |
| A1006 | Schlafsack Komfort -5°C | 7/7 | vollständig |
Standbild der laufenden Oberfläche, Auszug aus 10 Zeilen. Die Kachel „geschätzt: 0“ ist Absicht – sie hält fest, dass keine einzige Angabe automatisch ergänzt wurde, und sie bleibt auch dann auf null, wenn man im Eingabefeld Werte löscht.
Version 3 · KI-gestützte Vorschläge mit Nachprüfung
läuftDie Regeln finden die Lücke, füllen sie aber nicht. Genau zwei Felder bekommen einen Vorschlag, und aus verschiedenen Gründen. Für Beschreibungen formuliert ein Sprachmodell einen Satz – im Beispieldatensatz betrifft das vier der zehn Artikel: A1001, A1004, A1007 und A1009. Für Kategorien – im Beispiel nur A1010 – formuliert es nichts, sondern wählt aus: erlaubt ist nur, was im Kategoriebaum schon steht, und das wird zeichengleich geprüft. Passt keine bestehende Kategorie, erfindet das Modell keine, sondern schlägt bis zu drei neue vor – getrennt ausgewiesen, getrennt freizugeben und in der Datei mit einem eigenen Herkunftswert versehen.
Der interessante Teil dieser Stufe ist nicht der Vorschlag, sondern die Prüfung dahinter. Jede harte Angabe im Vorschlagstext wird gegen die Daten desselben Artikels gehalten: jede Zahl, jedes Material, jede Farbe, jede Eigenschaftsbehauptung. Was sich dort nicht findet, ist hinzuerfunden – und der Vorschlag lässt sich nicht übernehmen. Diese Prüfung läuft zweimal: einmal im Aufzeichnungsskript, bevor eine Antwort überhaupt gespeichert wird, und einmal im Browser des Besuchers gegen die Daten, die dort gerade im Feld stehen.
Vorschläge mit Nachprüfung ansehen →
0.75 steht im
Namen, Tritan im Feld Material,
transparent im Feld Farbe
Stirnlampe LED 300 Lumen · Konfidenz mittel
Standbild der laufenden Oberfläche für den Beispieldatensatz, Auszug aus fünf Vorschlägen. In diesem Lauf hat kein Vorschlag die Nachprüfung verfehlt – das ist das Ergebnis, nicht die Zusage.
Interessanter als ein sauberer Lauf ist der Fall, in dem die Prüfung greift. Er lässt sich nicht bestellen, aber nachstellen – die beiden folgenden Sätze stehen als Testfälle im Regelwerk und lassen sich in der Demo unter „Selbsttest“ ausführen:
1200 steht
in keinem Feld dieses Artikels
Zubehör,
aber nicht zubehör – im Shop wären das zwei
Menüpunkte
Der erste Satz klingt so plausibel wie jeder andere. Genau solche Sätze landen sonst im Shop, ohne dass jemand den Unterschied bemerkt.
Wohin ein freigegebener Vorschlag geht
Nicht in produkte_bereinigt.csv. Die Datei bleibt
zeichengleich zu dem, was das Python-Skript schreibt – dort steht
ausschliesslich, was aus den Rohdaten stammt. Eine Freigabe erzeugt
eine dritte Datei mit zwei zusätzlichen Spalten:
beschreibung_herkunft und
kategorie_herkunft.
Dort steht zu jedem Wert, woher er stammt: aus den Produktdaten oder aus einem freigegebenen Vorschlag. Ohne diese Spalten sehen beide nach ein paar Wochen gleich aus, und niemand kann mehr sagen, welchen Wert der Hersteller geliefert hat und welchen eine KI.
Was das Modell ausdrücklich nicht tut
Keine Preise, keine Materialien, keine Farben, keine Bild-URLs. Für solche Angaben gibt es weder eine Formulierung noch eine Auswahl, sondern nur den einen wahren Wert, den jemand nachsehen muss. Ein generierter Vorschlag wäre dort eine erfundene Angabe, die aussieht wie eine gepflegte – und im Shop landet, ohne dass jemand den Unterschied bemerkt.
Auch keine erfundene Kategorie. Vorschlagen darf das Modell nur, was im Katalog schon existiert; passt davon nichts, ist das ein ausgewiesener Vorschlag zur Erweiterung des Kategoriebaums und keine stillschweigende Einordnung.
Der Kern: A1010
Bei Artikel A1010 ist die Kategorie leer. Die Regeln könnten aus dem Namen „Stirnlampe“ eine Kategorie ableiten, tun es aber nicht, weil das Raten wäre. Der Artikel taucht stattdessen im Report auf, mit der konkreten Angabe, was fehlt.
Version 3 schlägt dafür Zubehör vor – und an diesem
Unterschied hängt alles. Der Vorschlag nennt seine Grundlage
(Stirnlampe LED 300 Lumen), er muss eine Kategorie
treffen, die es im Katalog wirklich gibt, und bis jemand ihn freigibt,
bleibt das Feld leer. Gibt jemand frei, steht der Wert nicht in der
bereinigten Datei, sondern in einer dritten, mit einer Spalte, die
seine Herkunft festhält.
Raten heisst: Der Wert steht da, und niemand weiss mehr, woher. Vorschlagen heisst: Der Wert steht zur Entscheidung, mit Beleg, und bleibt danach als Vorschlag erkennbar.
Automatisierung
- liest die Datei ein und prüft jedes Pflichtfeld
- wendet Namens- und Kategorieregeln einheitlich an
- lässt unbekannte Kategorien unverändert
- listet auf, was leer ist
Mensch
- wählt die Pflichtfelder aus
- definiert die Zuordnungstabelle
- ergänzt Beschreibungen, Preise und Bilder
- entscheidet, was in den Shop geht
Grenzen
- Keine PIM-Plattform, keine Datenbank, kein Import in ein echtes System – das Skript liest und schreibt CSV-Dateien.
- Keine automatische Beschaffung fehlender Informationen. Preise, Materialien, Farben und Bilder muss weiterhin ein Mensch liefern; für Beschreibung und Kategorie gibt es einen Vorschlag, keine Ergänzung.
- Im Regelwerk selbst steckt keine KI. Die Zuordnungstabelle steht fest im Code; was nicht darin steht, wird nicht zugeordnet. Nur die Vorschläge in Version 3 stammen aus einem Sprachmodell – und keiner davon gelangt ohne bestandene Nachprüfung und ohne menschliche Freigabe in eine Datei.
- Die Nachprüfung erkennt erfundene Zahlen, Materialien, Farben und Eigenschaftsbehauptungen, und sie erkennt eine Kategorie, die es im Katalog nicht gibt. Sie erkennt nicht, ob ein sachlich gedeckter Satz auch fachlich richtig ist oder ob eine existierende Kategorie die inhaltlich passende ist – das bleibt die Aufgabe der Person, die freigibt.
- Die Wortlisten für Materialien, Farben und Behauptungen sind kurz und explizit, nach demselben Prinzip wie die Abkürzungsliste. Was nicht darin steht, prüft die Nachprüfung nicht.
- Die Namensregel ist bewusst einfach: Abkürzungen bleiben nur dann groß, wenn sie in der Liste im Code stehen. Eine kurze, nachlesbare Liste statt einer Regel, die rät, was eine Abkürzung ist.
-
Die Beispieldaten sind Demonstrationsdaten; die Bild-URLs verweisen
auf die reservierte Beispieldomain
example.com.
Dateien
- produkte_roh.csv Eingabe
- pim_cleanup.py Logik
- produkte_bereinigt.csv Ausgabe
- missing_information_report.md Lücken
- rules-pim.js Regelwerk
- tests-pim.js Tests
- aufzeichnen.py Aufzeichnung
- pim-beschreibung.txt Prompt
- rules-pim-llm.js Nachprüfung
- tests-pim-llm.js Tests V3
- produkte_ergaenzt.csv Freigaben
- case_beschreibung.md Doku
pim_cleanup.py nutzt nur die Python-Standardbibliothek,
die Browser-Fassung reines JavaScript ohne Bibliotheken – kein
Internetzugriff, keine Datenbank. Einzige Ausnahme ist
aufzeichnen.py: Es braucht das Paket
anthropic und einen API-Schlüssel, läuft ausschliesslich
lokal und kommt nie ins Web-Verzeichnis. Im Netz liegen nur seine
Ergebnisdateien. Die vollständigen Dateien sende ich auf Anfrage
gerne zu.
Wenn Ihr Produktkatalog Lücken hat
Wenn Sie eine Rolle in Produktdaten, PIM oder E-Commerce besetzen: Dieser Fall stammt aus der Praxis bei Birner – 36.000 Artikel, rund 200 Kategorien, Dienstzeugnis liegt vor.