Python-Skript und Browser-Fassung
Gartenanfragen vorprüfen
Wer Gartenprojekte plant, bekommt Anfragen als formlosen Text – ein paar Zeilen E-Mail, in denen die Hälfte dessen fehlt, was für ein Angebot nötig wäre. Wer das übersieht, führt ein Erstgespräch und muss danach dieselben Fragen trotzdem stellen. Dieses Werkzeug liest die Anfrage gegen eine fachliche Checkliste und sagt vor dem Termin, was noch offen ist.
Projektanfragen auf Vollständigkeit prüfen: Welche Themen sind schon erwähnt, und wo muss vor dem Erstgespräch nachgefragt werden?
Was die Prüfung leistet
- 10 fachlich definierte Themen je Anfrage geprüft
- jeder Treffer nennt das Stichwort, das ihn ausgelöst hat
- fehlende Themen getrennt in kritisch und nicht blockierend
- vier Versionen: Python, Oberfläche, KI-Rückfragen, Modellvergleich
- aufgezeichneter Modelllauf: 26 von 30 Themen gleich eingestuft
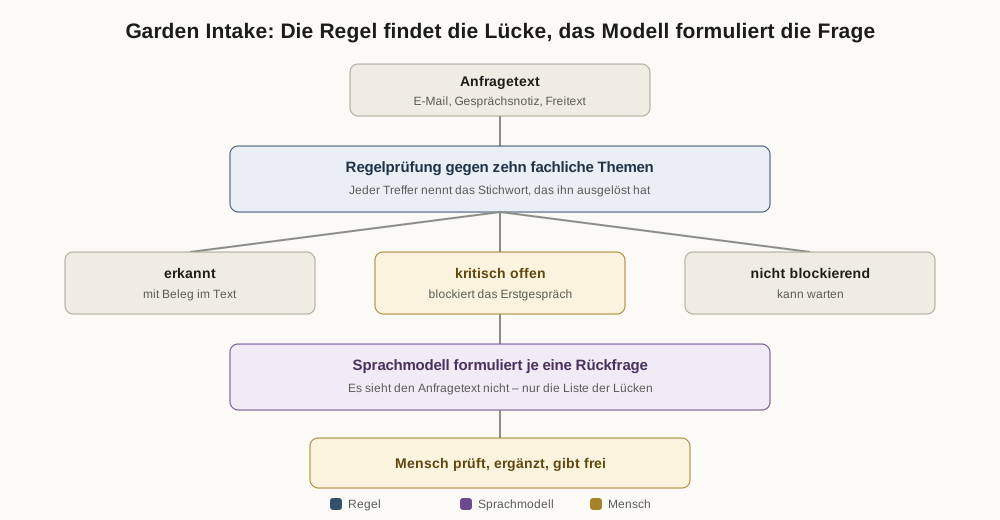
Der Fall als Prozess
- Auslöser
- Eine formlose Projektanfrage trifft ein – per Mail, Formular oder Telefonnotiz.
- Eingangsdaten
- Freitext, unstrukturiert, in jedem Fall anders vollständig.
- Regelwerk
- Zehn fachlich definierte Themen, die eine Gartenanfrage abdecken muss. Im Code nachlesbar, nicht im Modell versteckt.
- Prüfschritt
- Jeder Treffer wird mit dem auslösenden Stichwort ausgewiesen; fehlende Themen werden in kritisch und nicht blockierend getrennt.
- Ausgabe
- Ein Report mit drei Listen – erkannt, kritisch offen, nicht blockierend – und daraus formulierte Rückfragen.
- Übergabepunkt
- Der Mensch liest die Rückfragen, ändert sie oder verwirft sie und gibt frei. Nichts geht ungeprüft hinaus.
- Grenze
- Das Werkzeug prüft Vollständigkeit, nicht Machbarkeit. Eine fachlich falsche Angabe fällt ihm nicht auf – siehe Grenzen.
Was es tut
Liest eine formlose Anfrage, prüft sie gegen zehn fachlich definierte Themen, weist jeden Treffer mit dem auslösenden Stichwort aus und trennt fehlende Themen in kritisch und nicht blockierend. Läuft im Browser, in unter einer Sekunde.
Ausgangslage
Eine Anfrage für einen Privatgarten kommt selten als ausgefülltes Formular. Sie kommt als E-Mail, als Gesprächsnotiz oder als loser Text.
In so einem Text stecken viele planungsrelevante Angaben, aber sie sind über mehrere Absätze verteilt: die Ausrichtung nach Süden unter „Ausgangslage“, der Zeithorizont im ersten Absatz, der Kostenrahmen ganz am Schluss. Und was nicht dasteht, fällt beim Lesen naturgemäß am wenigsten auf – genau das ist aber vor einem Erstgespräch die wichtigere Information.
Was muss vor einem Erstgespräch geklärt sein?
Zehn Themen, die vor einem Erstgespräch geklärt sein sollten. Jedes ist im Code als kritisch oder nicht blockierend eingestuft:
- Grundstücksgröße
- Vegetation
- Boden
- Exposition
- Leitungen
- Nutzungswünsche
- Budget
- Zeitrahmen
- Rechtliches
- Pflegeaufwand
Ablauf
Version 1 · Python-Werkzeug
läuftEin Skript aus der Python-Standardbibliothek. Es liest die Anfrage, gleicht sie gegen die Checkliste ab und schreibt einen Report als Markdown-Datei. Keine Installation, keine Abhängigkeiten.
Eingabe · intake_beispiel.txt
Projektanfrage – Neugestaltung Privatgarten
Grundstücksgröße: ca. 650 m²
Wunsch: Neugestaltung des Gartens rund um einen
Neubau, Fertigstellung Haus voraussichtlich
Frühjahr nächstes Jahr.

Ausgangslage:
Das Grundstück ist derzeit Baustelle, Erdaushub
liegt noch teilweise auf der Fläche.
Der Garten ist nach Süden ausgerichtet, angrenzend
an ein Nachbargrundstück mit hoher Thujenhecke.
Ein alter Walnussbaum soll erhalten bleiben.

Wünsche der Familie:
- Terrasse direkt am Wohnzimmer, ca. 25-30 m²
- Rasenfläche zum Spielen für zwei Kinder
- Sichtschutz zur Straße
- Wenig Pflegeaufwand
- Wassersparend, falls möglich

Sonstiges:
Ein erstes Konzept mit grober Kostenschätzung
wäre hilfreich.
Auszug, gekürzt.
Ausgabe · intake_report.md
## Vorhanden

- **Grundstücksgröße/-lage** – gefunden
  (Stichwörter: m², grundstück)
- **Bestand: Vegetation/Bäume** – gefunden
  (Stichwörter: baum, hecke, walnuss)
- **Exposition/Lichtverhältnisse** – gefunden
  (Stichwörter: süden, osten, ausgerichtet)
- **Nutzungswünsche** – gefunden
  (Stichwörter: terrasse, rasen, spielen, …)
- **Budget/Kostenrahmen** – gefunden
  (Stichwörter: kostenschätzung, kosten)
- **Zeitrahmen/Termine** – gefunden
  (Stichwörter: frühjahr, fertigstellung)
- **Pflegeaufwand/Wasserbedarf** – gefunden
  (Stichwörter: pflegeaufwand, wassersparend)

## Fehlt – kritisch für die weitere Planung

- **Bodenbeschaffenheit**
- **Unterirdische Infrastruktur (Leitungen)**
- **Rechtliche Rahmenbedingungen**
Quellcode ansehen – Checkliste und Prüflogik
# Checkliste: Kategorie -> (Keywords zur Erkennung, kritisch?)
# Die Stichwörter sind bewusst eng gehalten. Ein zu breites Wort (z. B. "garten"
# für die Grundstücksgröße) würde fast jede Anfrage als vollständig ausweisen und
# damit echte Lücken verdecken.
CHECKLIST = {
    "Grundstücksgröße/-lage": (["m²", "grundstück"], True),
    "Bestand: Vegetation/Bäume": (["baum", "bäume", "hecke", "walnuss", "gehölz"], True),
    # "erdaushub" wurde bewusst entfernt: Aushub auf der Fläche sagt nichts über
    # die Bodenbeschaffenheit aus. Der Treffer hätte eine offene Frage verdeckt.
    "Bodenbeschaffenheit": (["boden", "lehm", "sand", "durchlässig"], True),
    "Exposition/Lichtverhältnisse": (["süden", "norden", "osten", "westen", "ausgerichtet", "sonnig", "schatten"], True),
    "Unterirdische Infrastruktur (Leitungen)": (["leitung", "kanal", "wasserleitung", "stromleitung", "drainage"], True),
    "Nutzungswünsche/Funktionsprogramm": (["terrasse", "rasen", "spielen", "gemüsebeet", "sichtschutz"], False),
    "Budget/Kostenrahmen": (["budget", "kostenschätzung", "€", "euro", "kosten"], True),
    "Zeitrahmen/Termine": (["frühjahr", "termin", "fertigstellung", "woche", "monat"], False),
    "Rechtliche Rahmenbedingungen (Bebauungsplan etc.)": (["bebauungsplan", "widmung", "baubehörde", "auflage"], True),
    "Pflegeaufwand/Wasserbedarf": (["pflegeaufwand", "pflegeleicht", "wassersparend", "bewässerung"], False),
}


def check_intake(text: str) -> dict:
    text_lower = text.lower()
    results = {}
    for category, (keywords, critical) in CHECKLIST.items():
        found_terms = [kw for kw in keywords if kw in text_lower]
        results[category] = {
            "gefunden": bool(found_terms),
            "treffer": found_terms,
            "kritisch": critical,
        }
    return results
Die Kernlogik ist durch acht kleine Tests abgesichert
(python3 intake_checker.py --selftest), die ohne
zusätzliche Abhängigkeiten laufen. Dieselben Regeln laufen als
JavaScript-Portierung im Browser – dort gegen 14 Testfälle, die Sie
selbst ausführen können.
Version 2 · Oberfläche
läuftDie Auswertung ohne Terminal. Diese Oberfläche ist gebaut und bedienbar: Das Regelwerk wurde nach JavaScript portiert und läuft im Browser des Besuchers – die gezeigten Werte werden dort berechnet, nicht eingetragen. Für dieselbe Anfrage liefert sie dasselbe Ergebnis wie das Python-Skript oben.
Oberfläche der Stichwortprüfung öffnen →
| Thema | Status | Beleg im Text |
|---|---|---|
| Grundstücksgröße/-lage | erkannt | m², grundstück |
| Bestand: Vegetation | erkannt | baum, hecke, walnuss |
| Exposition | erkannt | süden, ausgerichtet |
| Nutzungswünsche | erkannt | terrasse, rasen, spielen |
| Budget | erkannt | kostenschätzung |
| Bodenbeschaffenheit | offen | kein Beleg |
| Leitungen im Boden | offen | kein Beleg |
| Rechtliche Rahmen | offen | kein Beleg |
Standbild der laufenden Oberfläche, Auszug aus 10 geprüften Themen. Die Spalte „Beleg im Text“ ist bewusst fester Bestandteil: Ohne sie wäre nicht prüfbar, warum ein Thema als erkannt gilt.
Version 3 · KI-gestützte Rückfragen
aufgezeichnetDie Regeln finden die Lücke. Das Sprachmodell formuliert daraus die Frage, die im Erstgespräch tatsächlich gestellt wird – und nennt dazu, aus welcher Lücke sie stammt.
Diese Stufe ist einmal echt gelaufen: Das Modell hat nicht den Anfragetext bekommen, sondern nur die Liste der offenen Themen aus der Regelprüfung. Die Antwort wurde gegen die Vorgabe validiert und gespeichert. In der Demo steht sie mit Modellname, Datum und Token-Verbrauch daneben, dazu der Prompt und die Validierung im Klartext. Live geschaltet wird sie über eine Serverless-Funktion, in der der API-Schlüssel serverseitig liegt.
Aufgezeichnete Antwort in der Demo ansehen →
Entwurf aus 3 offenen Punkten – noch nicht freigegeben
Entwurf der Oberfläche, nicht bedienbar. Die Zeile „Grundlage“ unter jeder Frage ist der Kern: Man sieht, aus welcher Regel die Frage entstanden ist – nicht nur, dass ein Modell sie erzeugt hat.
Was das Modell auf dieser Stufe nicht tut
Es entscheidet nicht, ob ein Thema abgedeckt ist. Das bleibt bei der Checkliste. Das Modell bekommt den Anfragetext auf dieser Stufe gar nicht zu sehen – nur die Liste der Themen, die die Regeln als offen gemeldet haben.
Eine frühere Fassung dieser Seite hat das grundsätzlicher begründet: Ein Modell, das selbst einstuft, könne nicht mehr belegen, warum ein Thema als erkannt gilt. Das stimmt so nicht. Es kann – wenn man es zwingt, die Textstelle wörtlich zu zitieren, und diese Stelle anschliessend maschinell gegen den Text hält. Das Kriterium ist nicht „Regel oder Modell“, sondern „Beleg oder kein Beleg“. Genau darauf zielt Version 4.
Version 4 · Modellgestützte Analyse im Vergleich
aufgezeichnetDie Stichwortsuche erkennt Wörter, keine Bedeutung – das steht bei ihren Grenzen, und es stimmt. Diese Stufe prüft dieselben zehn Themen deshalb ein zweites Mal: mit einem Sprachmodell, das den vollen Anfragetext bekommt und beurteilen soll, ob eine Angabe planerisch ausreicht. Drei Stufen statt zwei – belegt, teilweise, nicht belegt.
Damit das nachprüfbar bleibt, muss das Modell zu jeder Einstufung die wörtliche Textstelle nennen, auf die es sich beruft. Diese Stelle wird gegen den Anfragetext gehalten – einmal vor dem Speichern der Aufzeichnung und noch einmal im Browser des Besuchers. Findet sie sich dort nicht, wird die Einstufung nicht übernommen, sondern als nicht verifizierbar ausgewiesen. Ohne diesen Schritt wäre die Modellausgabe nur eine Behauptung, die besser formuliert ist als die Regelausgabe – und dadurch schwerer zu widerlegen.
Der Erkenntniswert liegt nicht im Ergebnis der einen oder anderen Seite, sondern in den Abweichungen. Vier Fälle werden getrennt ausgewiesen:
| Fall | Was das bedeutet |
|---|---|
| Modell findet mehr | Die Angabe steht mit anderen Worten da – „der Untergrund staut nach Regen das Wasser“ ist eine Aussage zum Boden, auch ohne das Wort „Boden“. Der Fall, den eine Stichwortsuche prinzipbedingt verfehlt. |
| Modell stuft strenger ein | Das Stichwort greift, die Angabe reicht planerisch trotzdem nicht. „Süden“ nennt die Himmelsrichtung, sagt aber nichts über Verschattung durch Nachbarbebauung. |
| Modell widerspricht | Der Stichworttreffer ist ein Falschtreffer – dieselbe
Fehlerklasse wie damals bei erdaushub. |
| Beleg nicht auffindbar | Das Modell beruft sich auf eine Textstelle, die es so nicht gibt. Die Einstufung wird verworfen. Dass dieser Fall eine eigene Kategorie hat statt stillschweigend zu verschwinden, ist der Punkt der ganzen Stufe. |
Was der Lauf ergeben hat
Aufgezeichnet am 27. August 2026 mit claude-sonnet-5,
drei Anfragetexte, 6.831 Token rein und 8.042 raus. Über alle drei
Beispiele hinweg kamen Regel und Modell bei 26 von 30
Themen zum selben Schluss. Die vier Abweichungen sind der
Ertrag:
| Thema | Was das Modell zusätzlich sah |
|---|---|
| Exposition Anfrage Fam. R. |
„Der Garten ist nach Süden ausgerichtet, angrenzend an ein Nachbargrundstück mit hoher Thujenhecke.“ – Himmelsrichtung genannt, aber keine Aussage zur Verschattung. Nur teilweise belegt. |
| Budget Anfrage Fam. R. |
„Ein erstes Konzept mit grober Kostenschätzung wäre hilfreich.“ – Der Wunsch nach einer Schätzung ist kein genannter Budgetrahmen. |
| Rechtliches vollständige Anfrage |
Der Bebauungsplan ist erwähnt, die Auskunft der Auftraggeber ersetzt aber die eigene Prüfung nicht. |
| Nutzungswünsche sehr knappe Anfrage |
Der einzige Fall, in dem das Modell etwas findet, das die Stichwortsuche verfehlt – eine Umschreibung ohne hinterlegtes Stichwort. |
Kein einziger Beleg war erfunden. Alle 30 Textstellen ließen sich wörtlich im Anfragetext wiederfinden – vor dem Speichern und noch einmal im Browser. In keinem Fall hat das Modell einem Stichworttreffer widersprochen.
Die Einstufung der Checkliste bleibt die verbindliche. Das Modell liefert eine zweite Meinung mit Beleg, keine Ersetzung.
Der Erdaushub-Test – unabsichtlich bestanden
Weiter unten auf dieser Seite steht der Fehler, den die Demo selbst
sichtbar gemacht hat: Das Stichwort erdaushub galt
einmal als Beleg für die Bodenbeschaffenheit – fachlich falsch, und
es brauchte eine menschliche Korrektur an den Regeln. Dasselbe
Beispiel lief nun durch das Modell, ohne dass es von dieser
Geschichte wusste. Sein Urteil zur Bodenbeschaffenheit:
nicht belegt, mit der Begründung „Der Erdaushub liegt zwar
auf der Fläche, sagt aber nichts über die Beschaffenheit des
anstehenden Bodens aus.“ Es hat dieselbe Unterscheidung getroffen,
die die Regel erst nach der Korrektur trifft.
Ein Fehler, den die Demo selbst sichtbar gemacht hat
Der Beispieltext erwähnt, dass „Erdaushub noch teilweise auf der
Fläche liegt“. Eine frühere Fassung der Checkliste wertete das Wort
erdaushub als Beleg für das Thema Bodenbeschaffenheit –
fachlich falsch, denn Aushub auf der Fläche sagt nichts über den
anstehenden Boden aus.
Der Treffer hätte eine echte offene Frage als beantwortet erscheinen lassen. Das Stichwort wurde entfernt; das Thema erscheint jetzt korrekt als offener kritischer Punkt.
Auffindbar war der Fehler nur, weil der Report zu jedem Treffer das auslösende Stichwort mitschreibt. Das ist der eigentliche Grund, warum solche Werkzeuge ihre Begründung mitliefern müssen.
Automatisierung
- durchsucht den Text nach hinterlegten Stichwörtern
- ordnet Treffer den Themen zu und nennt das auslösende Wort
- trennt fehlende Themen in kritisch und nicht blockierend
Mensch
- definiert die Checkliste und die Stichwörter
- legt fest, welche Themen kritisch sind
- beurteilt, ob eine erkannte Angabe planerisch ausreicht
- führt die Bestandsaufnahme vor Ort durch
Grenzen
- Stichwortsuche ist keine fachliche Interpretation. Das Skript erkennt Wörter, nicht Bedeutung. Ein Text, der dasselbe Thema mit anderen Begriffen beschreibt, wird nicht erkannt. Genau diese Grenze adressiert Version 4 – und handelt sich dafür eine eigene ein: Ein Modell kann sich auf Textstellen berufen, die es nicht gibt. Deshalb wird dort jeder Beleg wörtlich gegen den Text geprüft, statt ihm zu glauben.
- Ein erkanntes Thema heißt nicht, dass die Information vollständig ist. „Süden“ reicht als Wort für einen Treffer, aber nicht für eine Planung.
-
Gesucht wird auch in Wortteilen:
kostenfindet deshalb auch „Kostenschätzung“. Das ist gewollt, kann aber im Einzelfall unerwartet greifen. - Die Prüfung ersetzt keine Bestandsaufnahme vor Ort. Alle fachlichen Entscheidungen bleiben beim Menschen.
- Die Beispielanfrage ist ein Demonstrationstext und enthält keine E-Mail-Adressen, Telefonnummern oder Anschriften.
Dateien
- intake_beispiel.txt Eingabe
- intake_checker.py Logik
- intake_report.md Ausgabe
- rules-garden.js Regelwerk
- tests-garden.js Tests
- anfragen.js Beispieltexte
- garden-analyse.txt Prompt V4
- rules-garden-llm.js Belegprüfung
- tests-garden-llm.js Tests V4
- case_beschreibung.md Doku
Das Skript nutzt nur die Python-Standardbibliothek, die Browser-Fassung reines JavaScript ohne Bibliotheken. In beiden Fällen: kein Internetzugriff, keine Datenbank. Die vollständigen Dateien sende ich auf Anfrage gerne zu.
In den Fachnotizen
Was aus diesem Fehler allgemein folgt – und die drei Regeln, die ihn sichtbar halten: Warum ein Stichwort kein Beleg ist →
Wenn bei Ihnen Anfragen unvollständig ankommen
Wenn Sie eine Rolle in Anforderungen, Prozessen oder Datenqualität besetzen: Das Regelwerk und die 37 zugehörigen Testfälle laufen im Browser – Sie müssen mir nichts glauben.